Dulu, menjalankan LLM (Large Language Model) lokal itu identik banget sama PC desktop. Kita selalu berasumsi butuh GPU kelas atas, file model yang gede, dan GUI runner yang ribet. saya punya setup seperti itu dan sebenarnya lancar-lancar aja.
Tapi, ada satu masalah kecil: keterbatasan VRAM di GPU saya yang bikin segalanya jadi serba nanggung.
Menariknya, perangkat yang justru paling sering saya pakai sehari-hari buat urusan AI malah HP saya sendiri. Performanya? Seringkali jauh lebih responsif dan bisa memuntahkan token lebih cepat dibanding setup desktop saya. Selama ini kita mungkin menganggap HP sebagai pilihan “kompromi” yang cuma bisa jalanin versi cupu dari alat yang ada di desktop.
Tapi untuk model open-weight sekarang, anggapan itu udah gak relevan lagi. Soalnya, masalahnya bukan di HP-nya yang canggih, tapi di desktop yang seringkali malah ‘kewalahan’ sendiri.
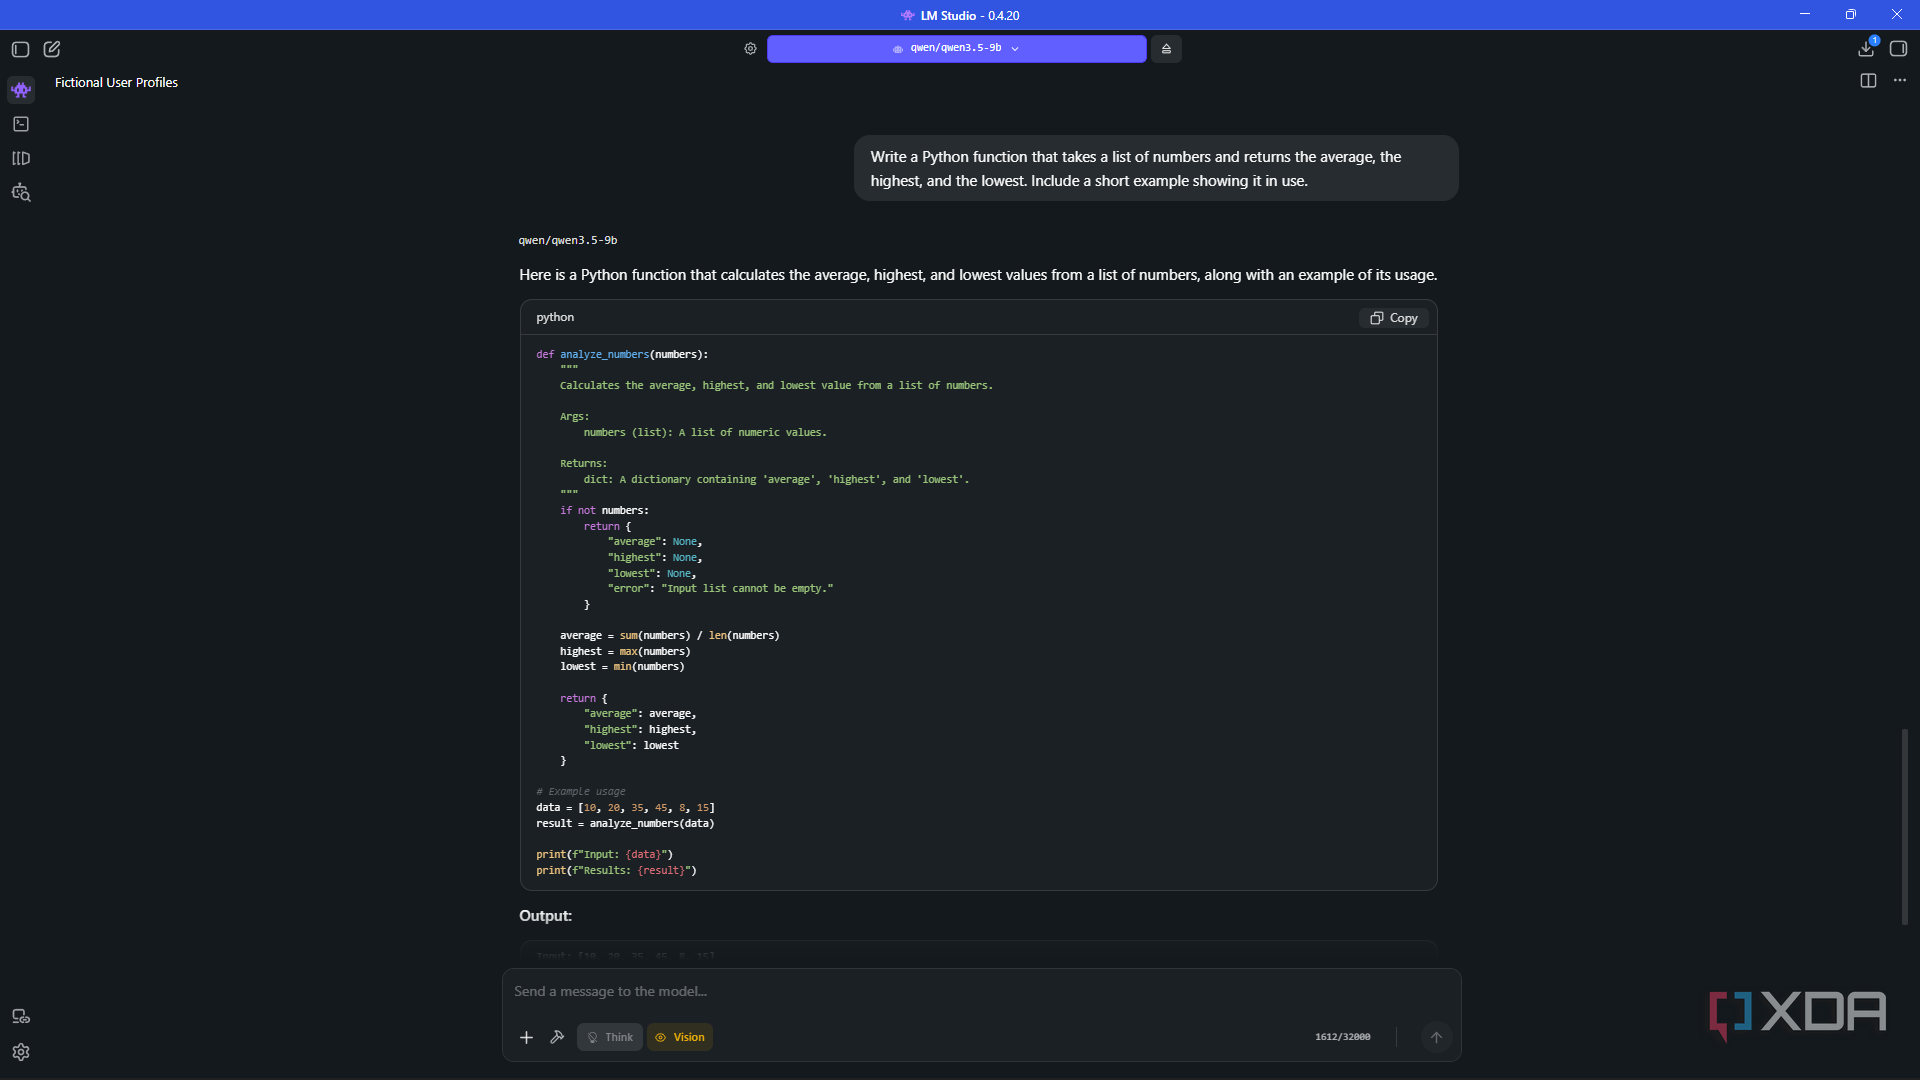
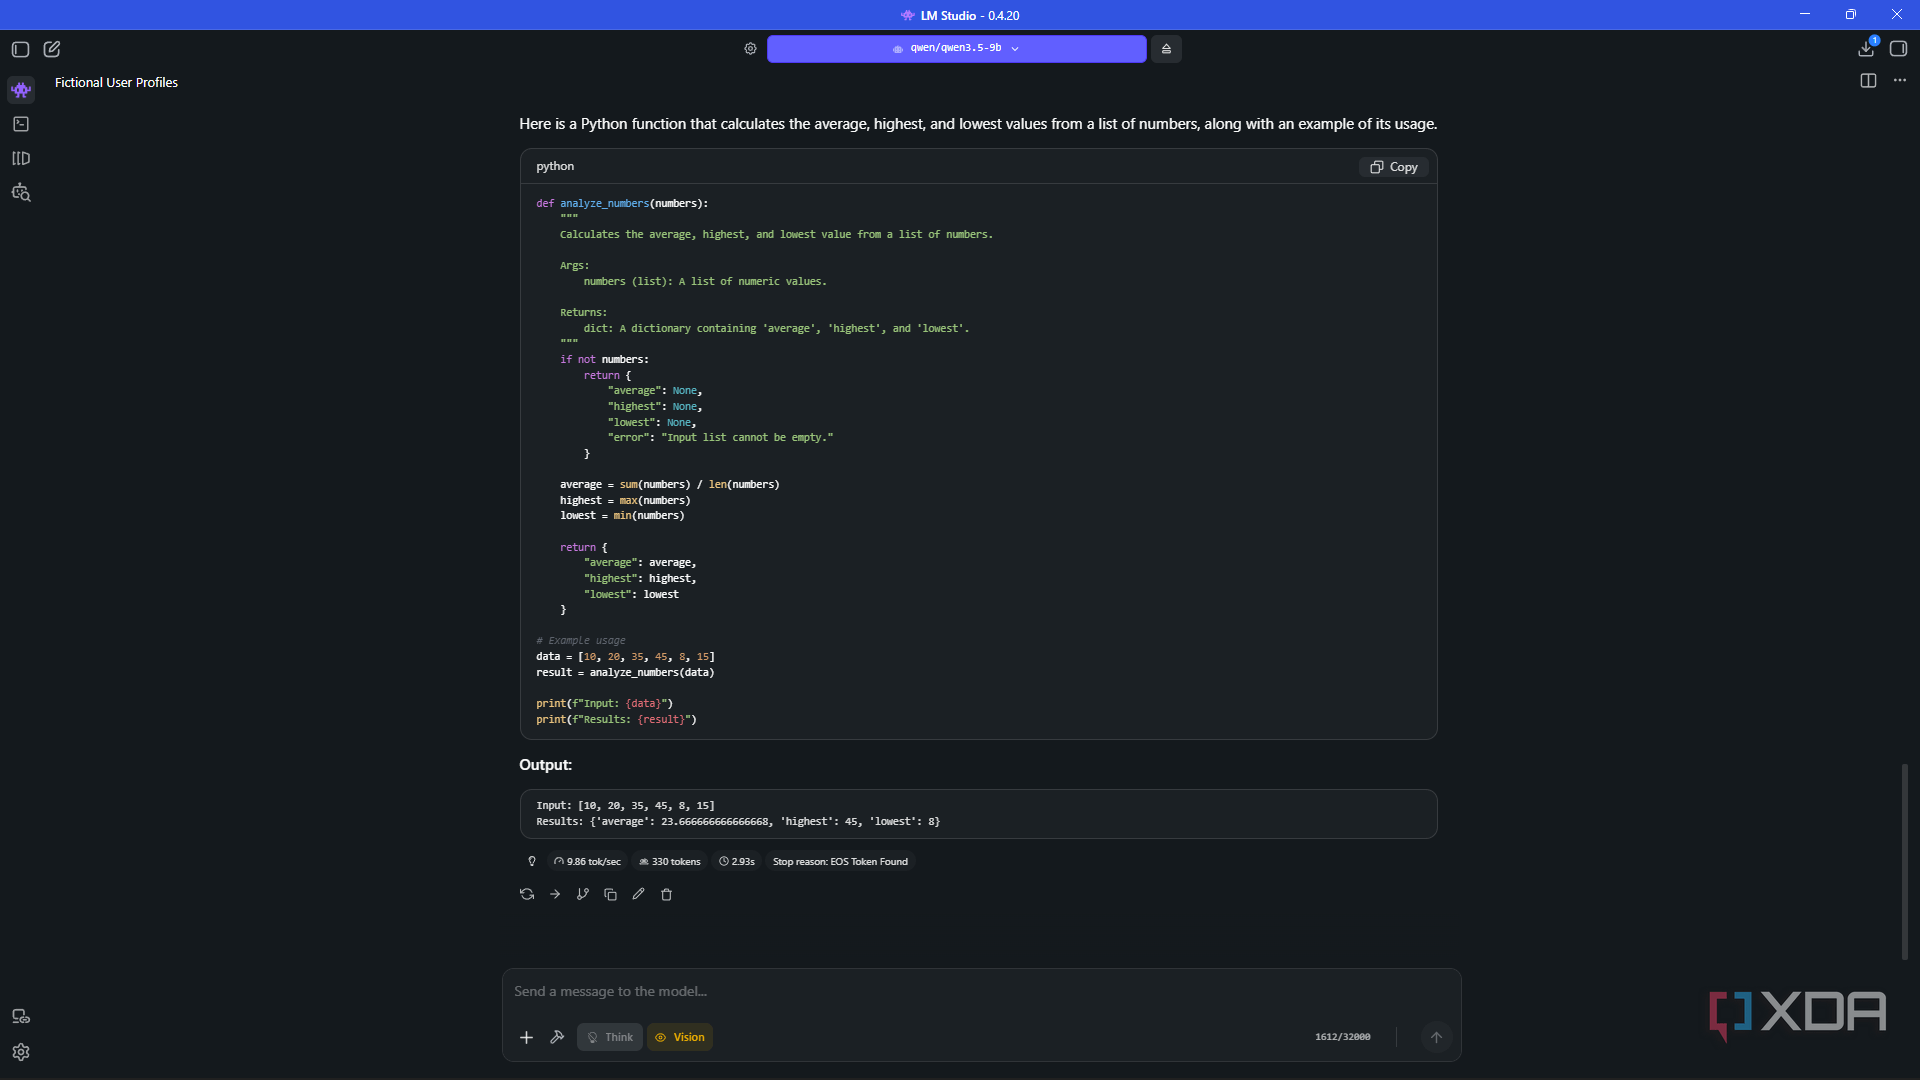
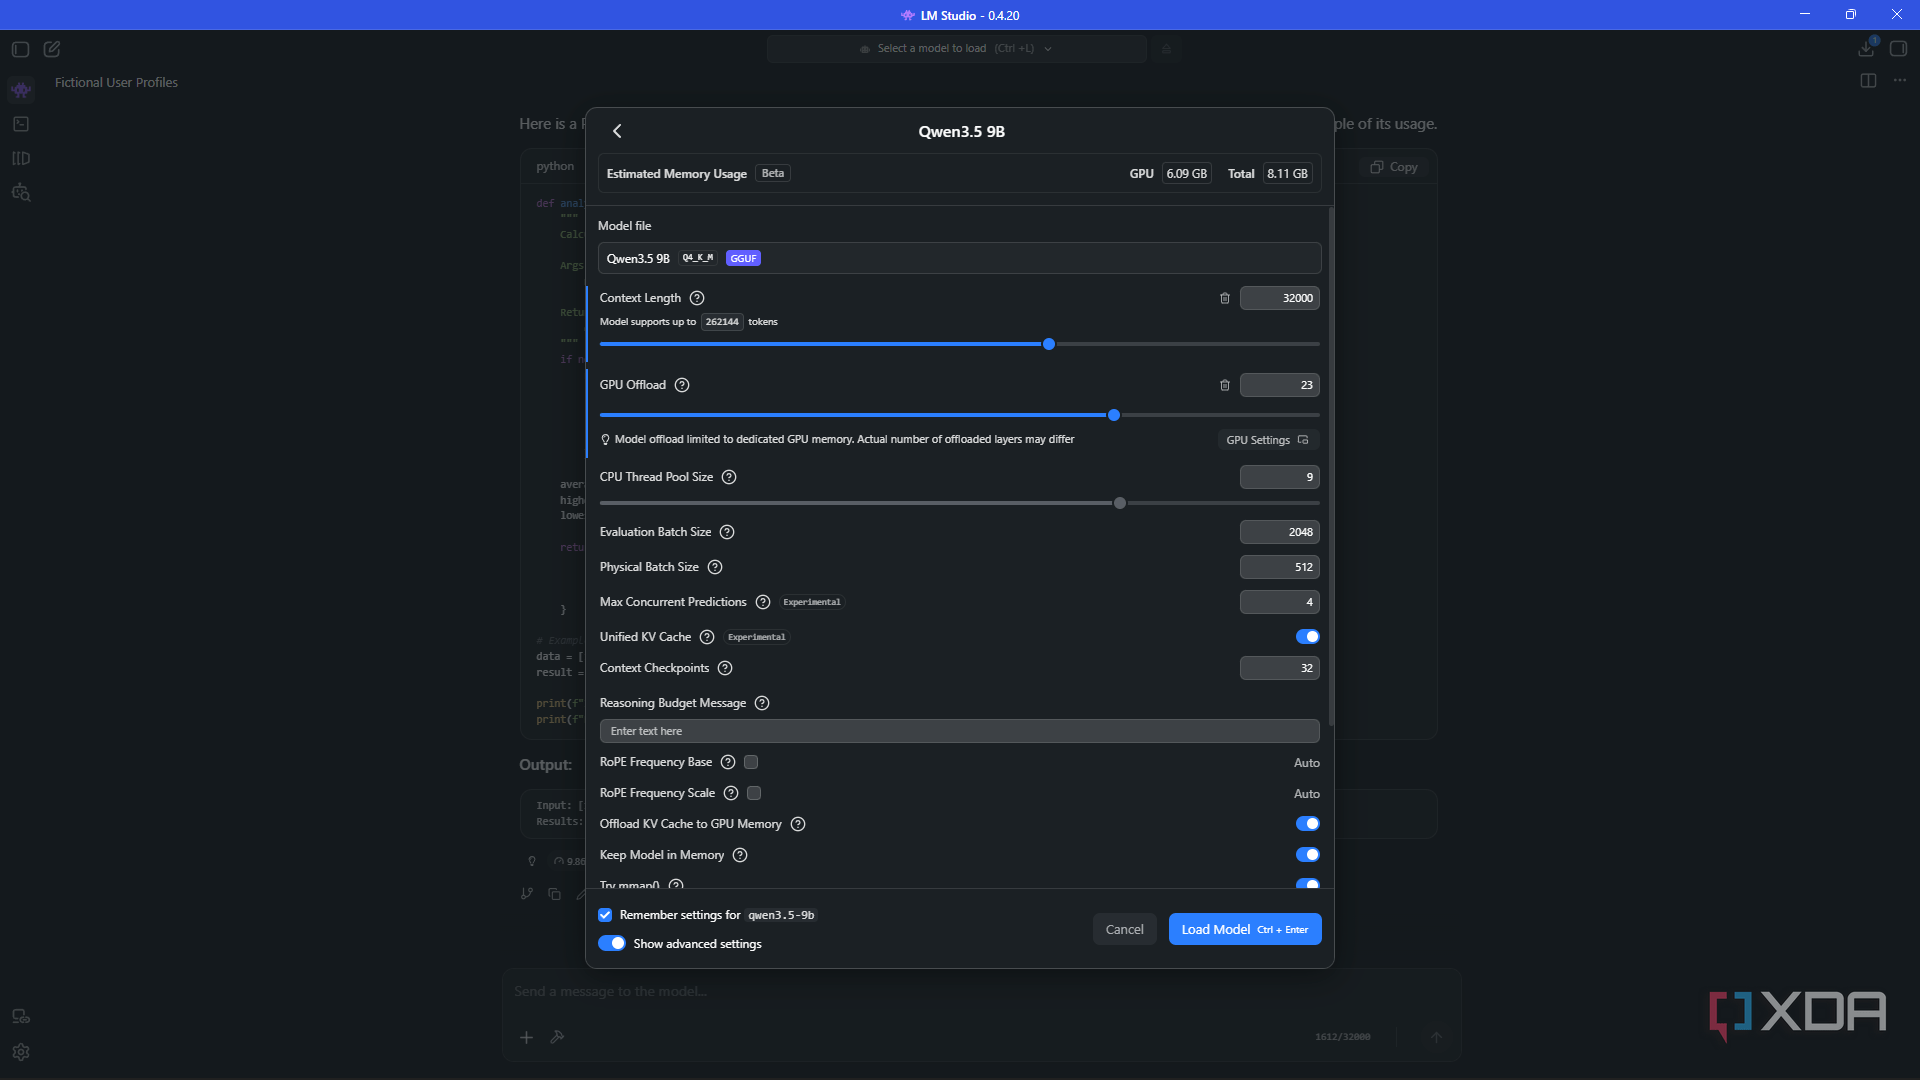
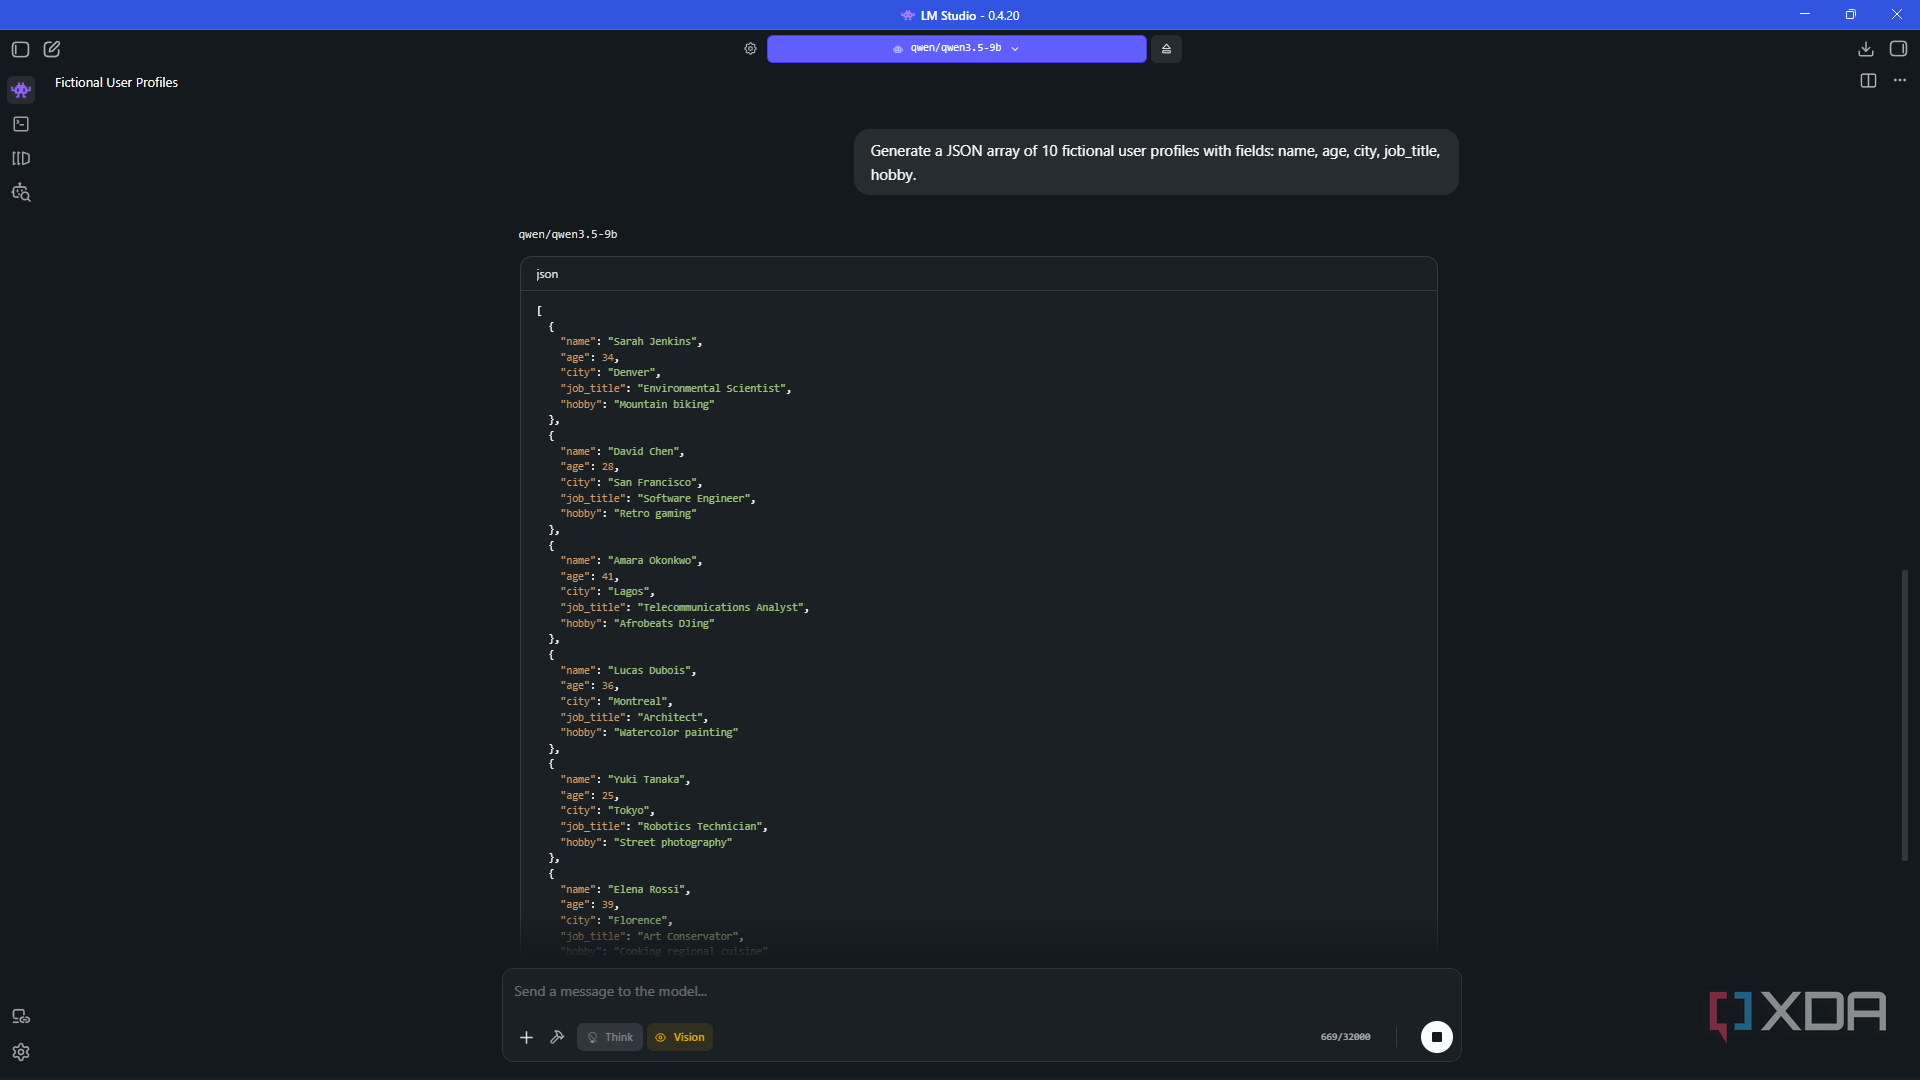
Setelah saya bandingkan berulang kali, hasilnya cukup bikin kaget. Model 4B di iPhone 16 saya bisa tembus 13 token per detik, bahkan model 2B bisa sampai 20+ token per detik. Sementara itu, model 9B di desktop saya—meski sudah saya otak-atik GPU offload-nya di LM Studio—cuma mentok di 9 token per detik. Padahal, saya masih harus nyisain VRAM biar browser, Figma, atau Obsidian tetap bisa jalan lancar. Kalau dipaksain, performanya langsung terjun bebas.
Masalah desktop itu ada pada manajemen VRAM. Kalau model 9B gak muat di GPU 8GB saya, sisanya bakal lari ke RAM sistem dan diproses pakai CPU. Di sinilah kecepatan jadi drop parah. Saya bisa sih mendedikasikan seluruh PC cuma buat LLM, tapi ya mana realistis buat kerja sehari-hari?
Nah, di HP, kita gak berhadapan dengan dilema itu. Model seperti Qwen 3.5 2B memang dirancang khusus buat dijalankan di smartphone. Gak ada tuh istilah ‘maksa’ hardware. Chip A18 pakai sistem unified memory, jadi dia gak perlu rebutan budget VRAM kayak di PC. Lagipula, jangan salah, model ‘kecil’ zaman sekarang udah jauh lebih pintar dibanding dulu. Qwen 4B aja benchmark-nya bisa setara sama model 80B generasi lama, lho.
Ini bukan soal menang-menangan setup
Desktop tetap punya keunggulannya sendiri
Tentu saja, kalau saya tutup semua aplikasi di desktop, performanya tetap juara. Model 9B atau 12B bisa ngebut di atas 20 token per detik, dan model kecil bisa tembus ratusan. Jadi, desktop masih menang telak kalau kita butuh parameter yang lebih besar untuk tugas berat seperti riset mendalam atau parsing dokumen panjang.
Satu lagi, ada masalah context window. Naruh dokumen riset yang panjang di model 2B HP bakal bikin memorinya cepat penuh, dan HP juga gampang panas kalau disuruh mikir kelamaan. Jadi, intinya bukan soal HP mengalahkan PC, tapi soal efisiensi. Ternyata, “fit” atau kesesuaian model dengan perangkat jauh lebih menentukan daripada sekadar adu kekuatan hardware. Dan buat saya, HP saat ini udah pas banget buat kebutuhan harian.